台湾のデータテクノロジーを牽引するリーディングブランド、BIG DATA(大數據股份有限公司)、政府機関の意思決定支援や国会・議会答弁準備といった用途に照準を定めた新ソリューション『KEYLM』インテリジェント秘書ソリューションの提供開始を発表しました。本ソリューションは、同社が10年以上にわたり蓄積してきた65億件を超える中国語コーパスを学習させた独自のドメイン特化型言語モデル「BIG10」とAIエージェントプラットフォームを組み合わせ、NVIDIA DGX Sparkをオンプレミスの計算基盤として採用しています。さらに、NVIDIA NeMo FrameworkやNVIDIA NeMo Agent ToolkitといったNVIDIAのソフトウェア技術を組み合わせることで、1台で完結するオンプレミス導入を実現しました。モデルのファインチューニングとエージェントのガバナンス能力を強化し、回答の追跡可能性とプロセスの監査を担保しながら、全体のパフォーマンスを同時に向上させています。
BIG DATA最高執行責任者(COO)兼スポークスパーソンの蔣 志薇は、「世界的にソブリンAI市場が急速に拡大するなか、公共部門ではデータのローカル保持とセキュリティガバナンスへの需要が高まり続けるなか、『KEYLM』はNVIDIAのハードウェア・ソフトウェア統合アーキテクチャを採用することで、繁体字中国語が国際的なAI学習データの中で長らく手薄であった領域を補うと同時に、政府機関が台湾のローカルな文脈を真に理解するAIモデルを活用し、知識の分散、人手による情報整理の負担、データをクラウドに上げられないという三つの課題を解決できるよう支援します」とコメントしました。
世界的なソブリンAIトレンドからBIG10へ
繁体字中国語の文脈を理解する鍵となる起点
市場調査会社Fortune Business Insightsの予測によると、世界のソブリンクラウド市場規模は2026年の1,953億5,000万米ドルから2034年には1兆3,185億7,000万米ドルまで拡大し、年平均成長率(CAGR)は27%に達すると予測しています。同社は、政府や公共部門がデータのローカル保持とセキュリティガバナンスを重視していることが、この市場成長の主要な原動力の一つだと指摘しています。これは、オンプレミス導入やデータを域外に出さない運用が、もはや一部の政府に限られた特殊なニーズではなく、世界の公共部門が共通して直面するAI導入の課題になりつつあるということです。
台湾の政府機関では、各部門の知識が公文書・会議録・報告書・答弁資料の間に分散し、急な答弁準備や政策説明のたびに膨大な人員を投入した調査を強いられてきました。加えて、人手による情報整理は品質にばらつきがあり、そのスピードにも限界があります。とりわけ重要なのは、政府の機密データを外部やクラウドに送信することができず、あくまでオンプレミスで運用し、データを組織の外に出さないこと、そして回答の出所を追跡でき、プロセスを監査できることが求められる点です。台湾のローカルな文脈を真に理解するAIモデルが必要とされる背景には、繁体字中国語が世界のAI学習データの中で長らく手薄に扱われてきたという現実があります。代表的なオープンな多言語大規模言語モデルであるBLOOMを例に取ると、学習コーパスに占める英語の割合は3割を超え、簡体字中国語も約16%を占める一方、繁体字中国語に関するコーパスは独立した項目として集計すらされてきませんでした。国際的な主流AI学習データにおいて繁体字中国語への関心が長年不足していた実態を映し出しています。
BIG DATAが10年以上にわたり蓄積してきた65億件を超える中国語コーパスを厳選し、ファインチューニングを重ねて開発したのが「BIG10」であり、まさにこのギャップを埋めるために構築された領域特化型言語モデルです。インテリジェント秘書ソリューションは、こうしたセキュリティ要件を満たしたうえで、機関内部の文書、業務データ、外部の世論情報を統合し、即時応答、即時レポート作成、世論分析、ナレッジガバナンスという四つの機能を提供します。これにより、政府における知識活用を、人手による検索からAIによる即時応答型の意思決定支援へと引き上げます。
一台のマシンに、三層のアーキテクチャ
プラットフォーム・モデル・計算基盤が連動する『KEYLM』、NVIDIA DGX Sparkがインテリジェント秘書を駆動
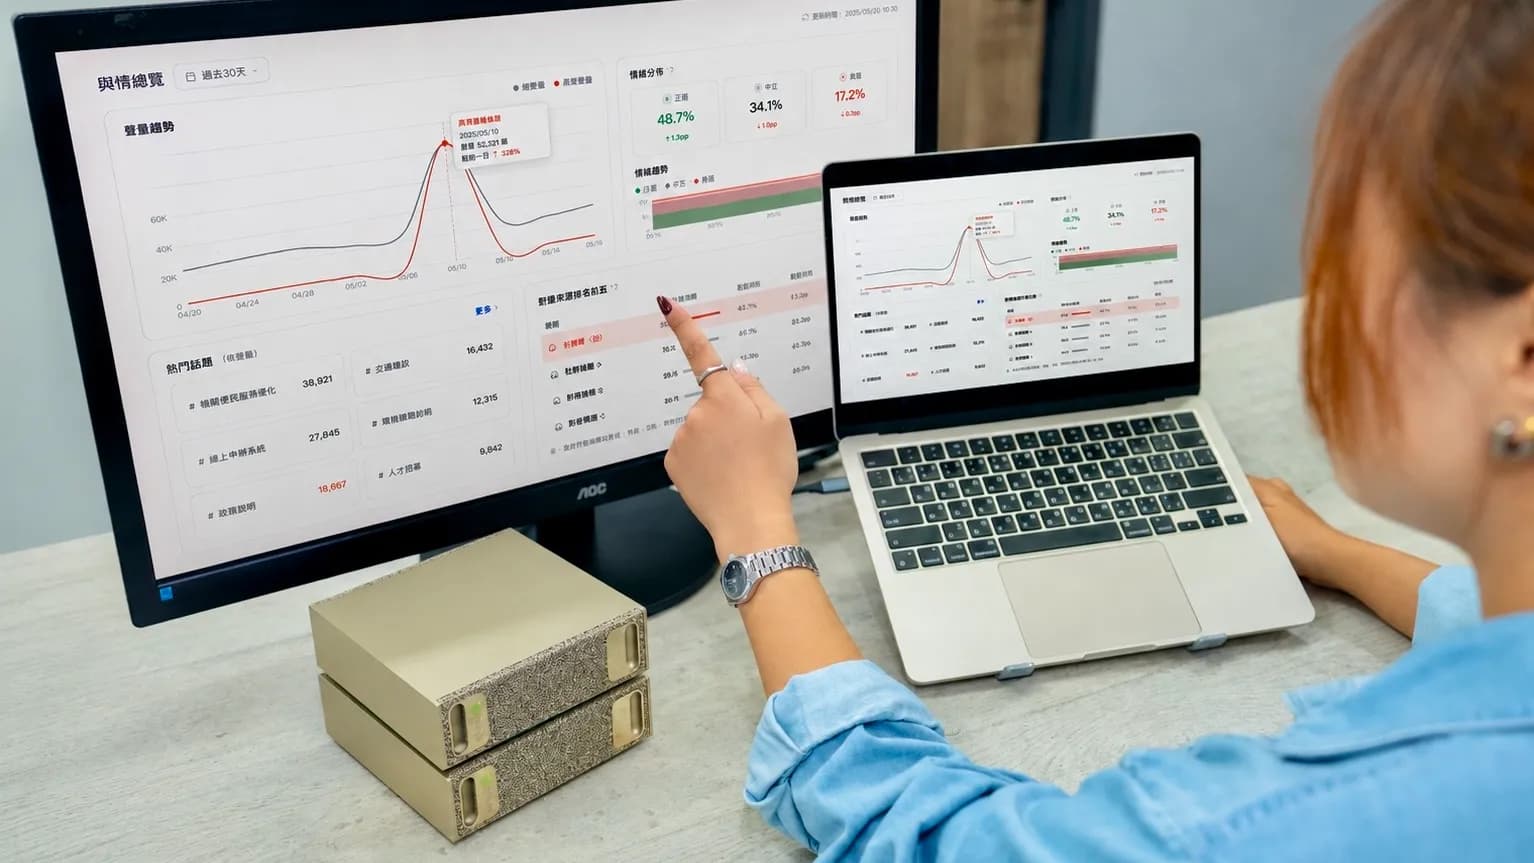
『KEYLM』は、プラットフォーム、モデル、ハードウェアの三層からなるハードウェア・ソフトウェア統合ソリューションです。プラットフォーム層にあたる「KEYLM Agent Platform」は、企業や政府内部のAIデータ中台(データ統合基盤)として機能し、四層構造のシステムアーキテクチャ、ナレッジベース管理、出所を追跡できるRAG型の質疑応答、エージェントワークフロー、長期記憶、そして権限ガバナンスや利用量管理といった機能を備えています。エージェントのガバナンスにはNVIDIA NeMo Agent Toolkitを採用し、AIエージェントのワークフローの構築、運用、最適化をに活用。パフォーマンス分析、可観測性、評価機能を提供することで、エージェントの挙動を追跡、評価、監査できるようにするとともに、ワークフロー層では、大規模言語モデルの呼び出し回数、トークン使用量、全体の遅延を削減しています。
BIG DATAが10年にわたり蓄積してきた65億件を超える繁体字中国語コーパスをファインチューニングして開発したドメイン特化型言語モデル「BIG10」は、台湾のローカルな文脈や官公庁特有の用語を理解できるモデルであり、タスクの機密性に応じてクラウド上の大規模モデルと柔軟に切り替えて使用することも可能です。モデルのファインチューニングにはNVIDIA NeMo Frameworkを採用し、データ整備、匿名化(非識別化)、ドメイン特化のファインチューニング、評価といった機能を通じて、繁体字中国語のドメイン知識をモデルに注入しています。なかでも匿名化機能は、政府機関というユースケースにおいて特に重要な役割を果たします。ハードウェアである「KEYLM Box」は、NVIDIA GB10 Grace Blackwellスーパーチップと128GBのユニファイドメモリを搭載したNVIDIA DGX Sparkを1台搭載しており、この1台だけでAIエージェントプラットフォーム、BIG10モデル、ナレッジ検索を同時に稼働させることができます。これにより、インテリジェント秘書ソリューション全体をオンプレミスで実装し、データを組織の外に出さない運用を実現しています。BIG DATAがDGX Spark上で推論の最適化を行った結果、最適化前の同クラスのオープンソースモデルと比較して、メモリ使用量は約半分に抑えられ、応答速度は約2倍に向上しました。
一般的な多くの企業向けAIソリューションは、相応の規模のサーバーやサーバールームへの投資を必要としますが、『KEYLM』はAIエージェント型のインテリジェント秘書に求められる機能一式を、デスクサイドに置ける大きさのDGX Spark1台に凝縮しており、1台で1つの機関のインテリジェント秘書業務を担うことができます。BIG DATAは今後も、既存のデータ資産と技術開発力を土台に、NVIDIAをはじめとする業界標準の技術アーキテクチャを採用しながら、AIソリューションの実装スピードを加速させ、より多くの政府機関や企業が、台湾のローカルな文脈に真に寄り添った、信頼できるAIアプリケーションを構築できるよう支援してまいります。
関連する記事
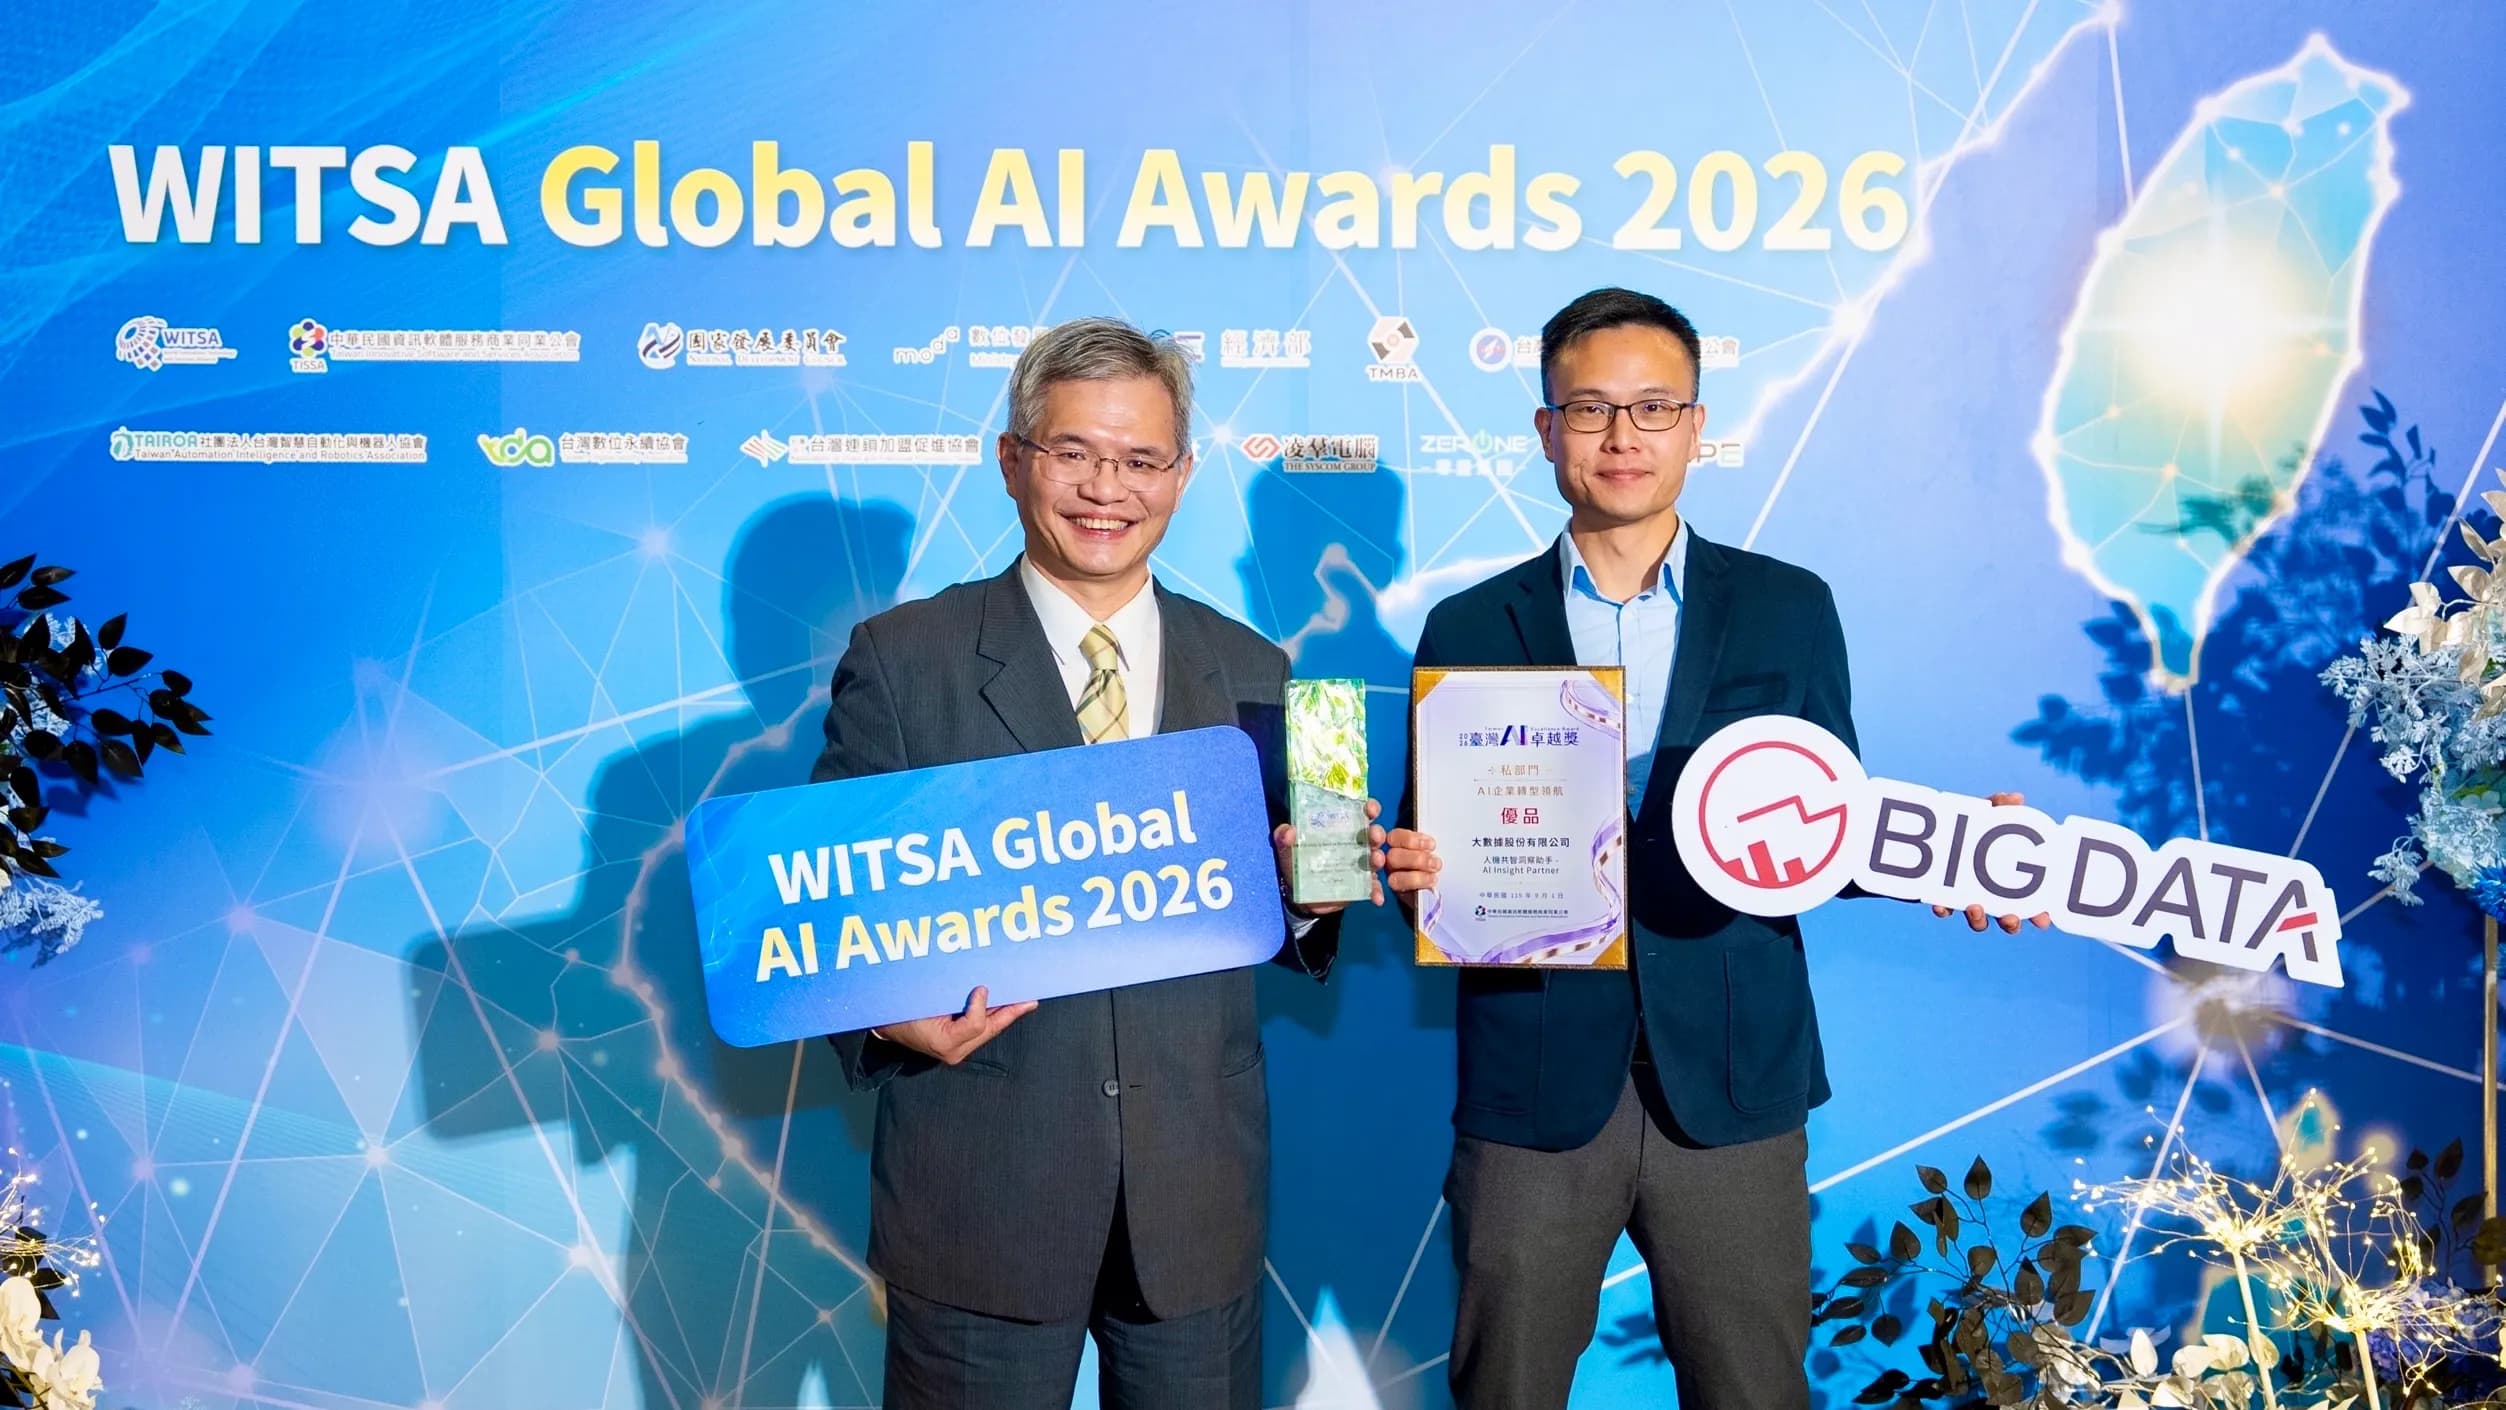
台湾発AIの実力、国内外で評価を獲得!BIG DATAがWITSA Global AI Awards、台湾AI卓越賞を受賞
台湾のデータテクノロジリーディングブランドであるBIG DATA(大數據股份有限公司)は、AI技術と企業への実装実績が国内外でダブルに評価され、本日(7日)、企業級ナレッジAIエージェントプラットフォーム『KEYLM』が「WITSA Global AI Awards 2026」の「The WITSA Global Award for AI Entrepreneurship」を受賞したことを発表しました。あわせて、「AI Insight Partner(人と機械が知を共創するインサイトアシスタント)」も、第1回「台湾AI卓越賞(Taiwan AI Excellence Award)」の「AI企業転換部門:優品」を受賞しています。BIG DATA総経理の温紹郁と最高技術責任者(CTO)の孟令三は、「2026台湾AI卓越賞」授賞式ならびに「WITSA Global AI Summit」晩餐会に会社を代表して出席し、デジタル発展部部長の林宜敬氏、WITSA会長のDato' Dr. Sean Seah氏、そして中華軟体公会(TISSA)理事長の沈柏延氏より、それぞれの賞を授与されました。孟令三CTOは翌日開催されたWITSA Global AI Summitにも登壇し、『KEYLM』のデモンストレーションを行い、企業内部の組織ナレッジの観点から、企業のAI転換における実際の現場実装の課題をいかに解決するかを示しました。 BIG DATA総経理の温紹郁は、「企業のAI導入は次の段階に入りつつあります。求められているのは、より高性能なモデルだけではなく、AIが企業自身のデータ、知識、業務プロセスを本当に理解できるかどうかです」と述べています。今回の2つの受賞は、エンタープライズ向けのオンプレミスAIからAIによる業務フロー変革を網羅するもので、データ、モデル、企業ナレッジを実際のビジネス価値へと転換し、AI技術の研究開発から産業への実装へと歩みを進めてきたBIG DATAの実力を物語っています。今後もAIと企業ナレッジ、データ、そして人の専門性との協働をさらに深化させ、より多くの企業がAIを日常の業務運営や意思決定に真に取り入れられるよう支援してまいります。
東京や大阪だけじゃない 台湾人が「再訪の時代」へ 福岡の言及量は前年比85%超増加
日本旅行が「最初にどこへ行くか」から「次はどこへ行けるか」を考える段階へと移り変わるなか、台湾人観光客の訪日旅行勢力図が変化しています。台湾のデータテクノロジーをリードするブランドであるBIG DATA(大數據股份有限公司)は本日(27日)、最新のインサイトレポート「日本の地方部が大逆襲!台湾人の好奇心をつかむ、新たな旅先とは」を発表しました。同社のAI世論分析ツール『KEYPOビッグデータ検索エンジン』を用いて、2023年1月1日から2026年5月31日までの台湾人の訪日旅行に関するインターネット上の言及量を分析した結果、台湾人観光客の関心が三大都市圏以外の地方へと持続的に広がっていることが明らかになりました。2026年の1月から5月までの5カ月間で、地方に関する旅行言及量の比率は35%に達し、2023年の29%から明確に上昇しました。一方、三大都市圏の比率は51%から年々低下しており、台湾人観光客の日本旅行の選択肢が徐々に地方へと広がっていることを示しています。なかでも福岡県は、台湾からの直行便就航や、車での移動による九州一帯の周遊のしやすさ、そしてトレンドのディープツーリズムを追い風に、前年比85.49%という言及量の伸びを記録し、地方成長率ランキングの首位に立ちました。熊本県、沖縄県もそれぞれ46.36%、45%の伸びで続き、訪日旅行地図における最も注目すべき「地方のダークホース」となっています。BIG DATA最高執行責任者(COO)兼スポークスパーソンの蔣 志薇は、「台湾人観光客の訪日経験が積み重なるとともに、地方への直行便の増加やレンタカー・チャーター車の普及も進み、旅行の意思決定は人気観光地での写真撮影から、現地でのディープツーリズムへとシフトしています」と述べています。地方の台頭は単に人気目的地の順位が変わったというだけでなく、台湾人が地方の探索、個人の興味、そして深い体験を核とする「再訪の時代」へと本格的に突入したことを表しており、観光事業者、航空会社、そして地方自治体にとって、戦略の立て直しを促す重要なシグナルであると述べています。
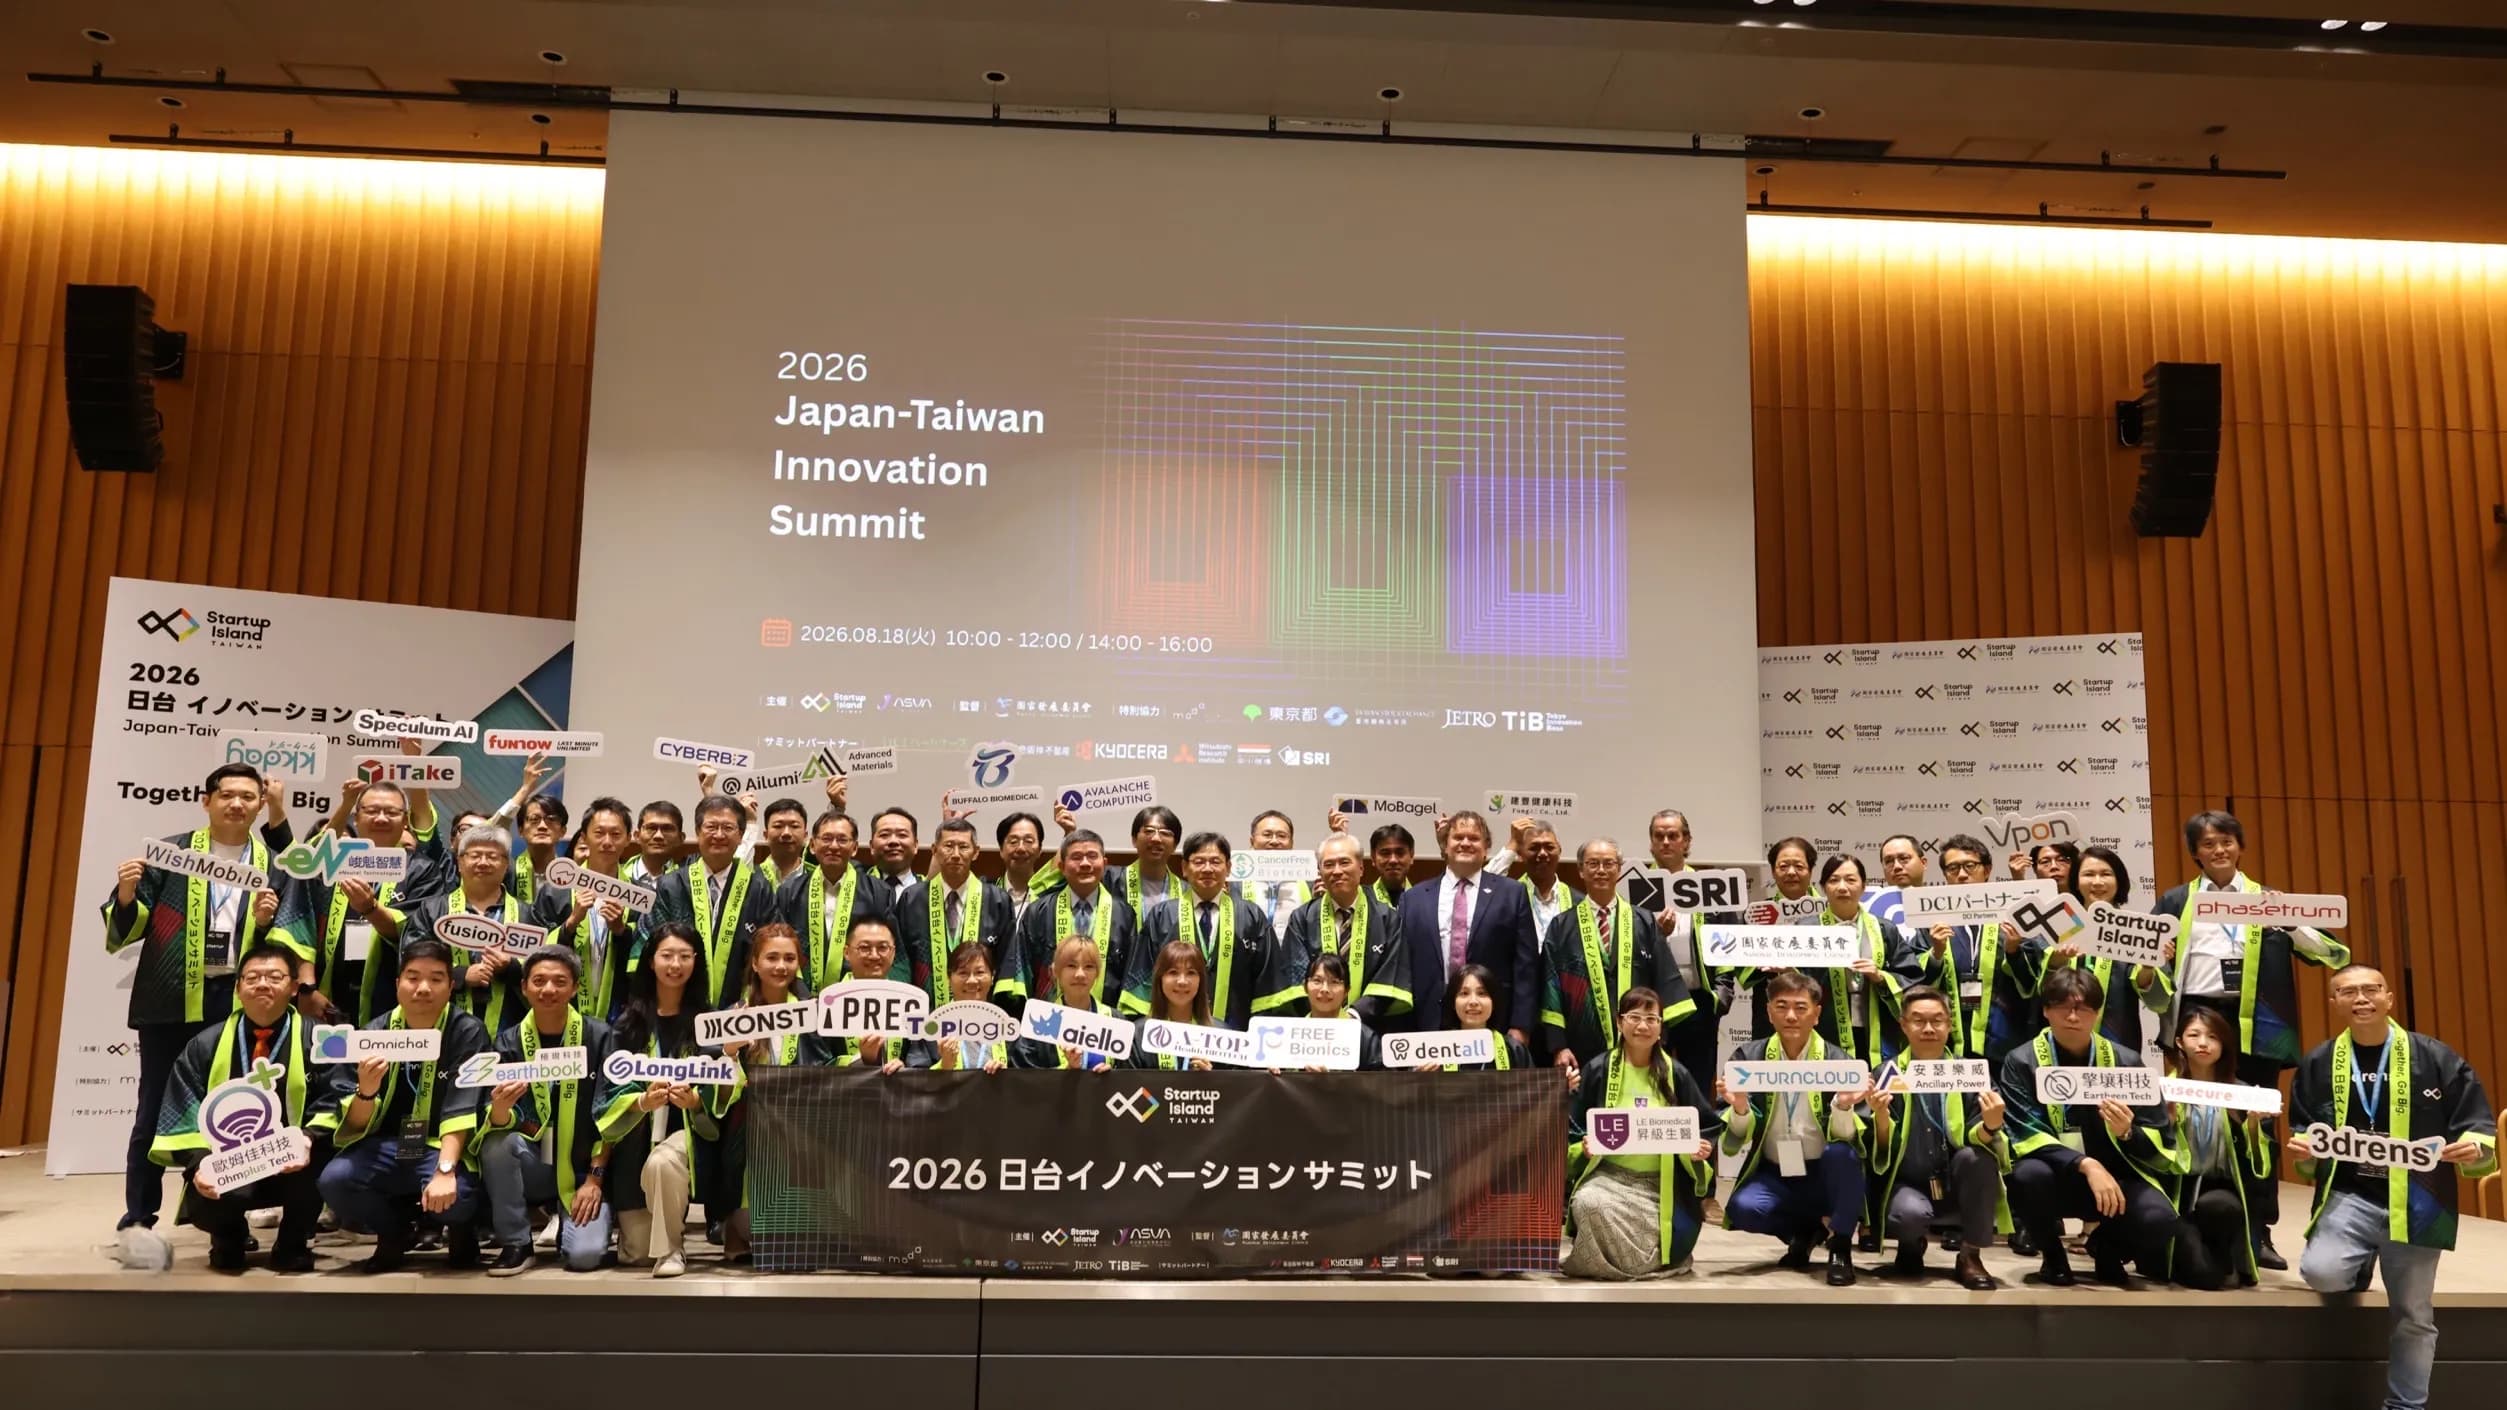
海外展開を加速!BIG DATAが「2026日台イノベーションサミット」に出席
台湾のデータテクノロジーをリードするBIG DATA(大數據股份有限公司、本社:台湾)は、今年4月に初めて日本市場へ進出し「SusHi Tech Tokyo」に参加、7月には香港で「2026 LEAP East」に出展したのに続き、8月18日から19日にかけて、台湾の国家発展委員会が創設した国家スタートアップブランド「Startup Island TAIWAN」主催による年次フラッグシップ国際イノベーションイベント「2026日台イノベーションサミット(Japan-Taiwan Innovation Summit 2026)」に初めて参加しました。会場には台湾国家発展委員会の葉俊顯主任委員、東京都の小池百合子知事、日本貿易振興機構(JETRO)の高島大浩理事をはじめとする日台双方の要人が集まり、台湾のスタートアップにとって日本最も注目度の高い年次交流の場の一つとなりました。BIG DATAは、日本企業や産業パートナーに向けて、全面刷新した『KEYPO Agent』と、企業向けナレッジAIエージェントプラットフォーム『KEYLM』という二つのAIソリューションを展示。AI、データガバナンス、そして企業の意思決定支援における台湾の技術力を示すとともに、現地パートナーシップ機会を継続的に模索し、日本市場での展開を深めています。BIG DATAのCOO兼スポークスパーソンである蔣 志薇は、「日本は当社の海外展開における重要な市場の一つであり、国際展示会への参加や現地企業との接点構築、技術面・商業面での協業機会の開拓を通じて、継続的かつ長期的な市場開拓を進め、日本企業が実際に抱えるニーズをより深く理解しながら、台湾で培ってきた成熟したデータやAI活用の知見を日本市場へ届けていきたいと考えています」と述べました。